-
Writing effective tools for agents 읽기 — 에이전트를 위한 도구 설계AI 하네스 2026. 10. 18. 04:57
Anthropic은 2025년 9월 11일 Writing effective tools for agents — with agents를 냈다. 에이전트가 쓰는 도구를 만들고, 평가하고, 고치는 방법에 대한 글이다. 도구를 만드는 순서와 설계 원칙 다섯 가지를 원문을 따라 정리했다.
들어가며: 도구란 무엇인가
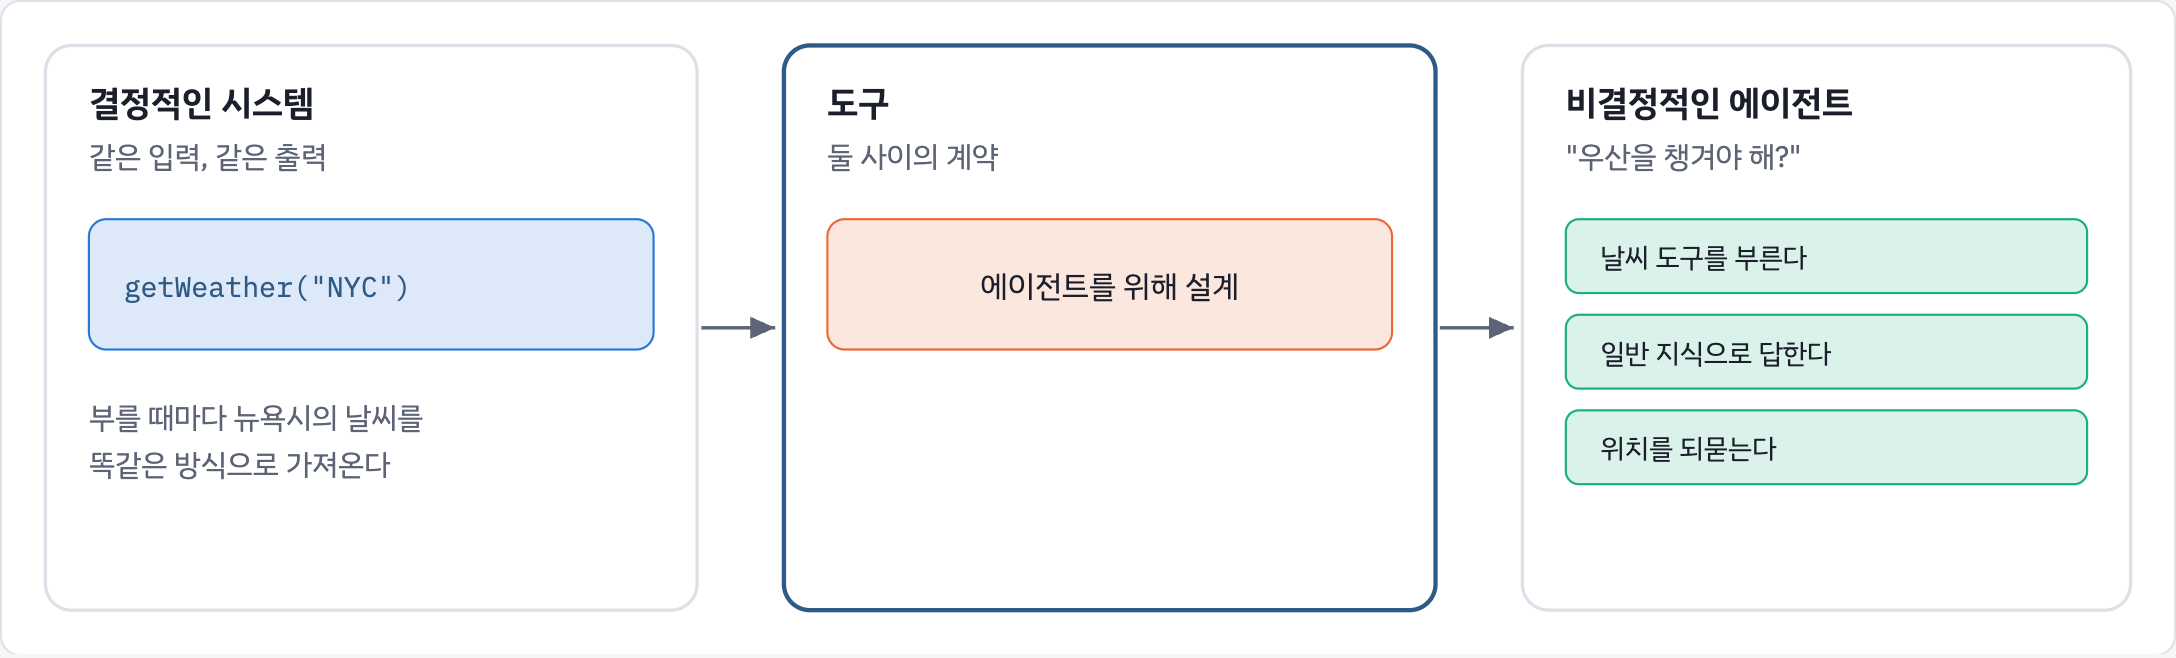
Anthropic은 이 글에서 도구를 "결정적인 시스템과 비결정적인 에이전트 사이의 계약을 담은 새로운 종류의 소프트웨어"라고 부른다. 결정적(deterministic)이라는 말은 같은 입력을 주면 언제나 같은 출력이 나온다는 뜻이다. 비결정적(non-deterministic)이라는 말은 같은 조건에서도 응답이 달라질 수 있다는 뜻이다. 여기서 에이전트는 LLM(대규모 언어 모델)이 도구를 호출해 과제를 푸는 시스템이다.
원문이 드는 예는 날씨 함수다.
getWeather("NYC")는 호출할 때마다 똑같은 방식으로 뉴욕시의 날씨를 가져온다. 에이전트는 다르다. 사용자가 "오늘 우산을 챙겨야 해?"라고 물으면 에이전트는 날씨 도구를 호출할 수도 있고, 일반 지식으로 답할 수도 있고, 먼저 위치를 되물을 수도 있다. 에이전트가 가끔 없는 사실을 지어내거나(hallucinate) 도구 쓰는 법을 이해하지 못하기도 한다고 원문은 적는다.그래서 도구와 MCP 서버를 다른 개발자나 시스템이 쓸 함수·API처럼 쓰지 말고 에이전트를 위해 설계해야 한다는 것이 원문의 출발점이다. MCP(Model Context Protocol)는 에이전트가 외부 도구에 접근하는 방식을 정한 규격이다. 원문은 MCP가 LLM 에이전트에게 수백 개의 도구를 쓸 수 있게 해 줄 수 있다고 적는다.
1부. 도구를 만드는 순서
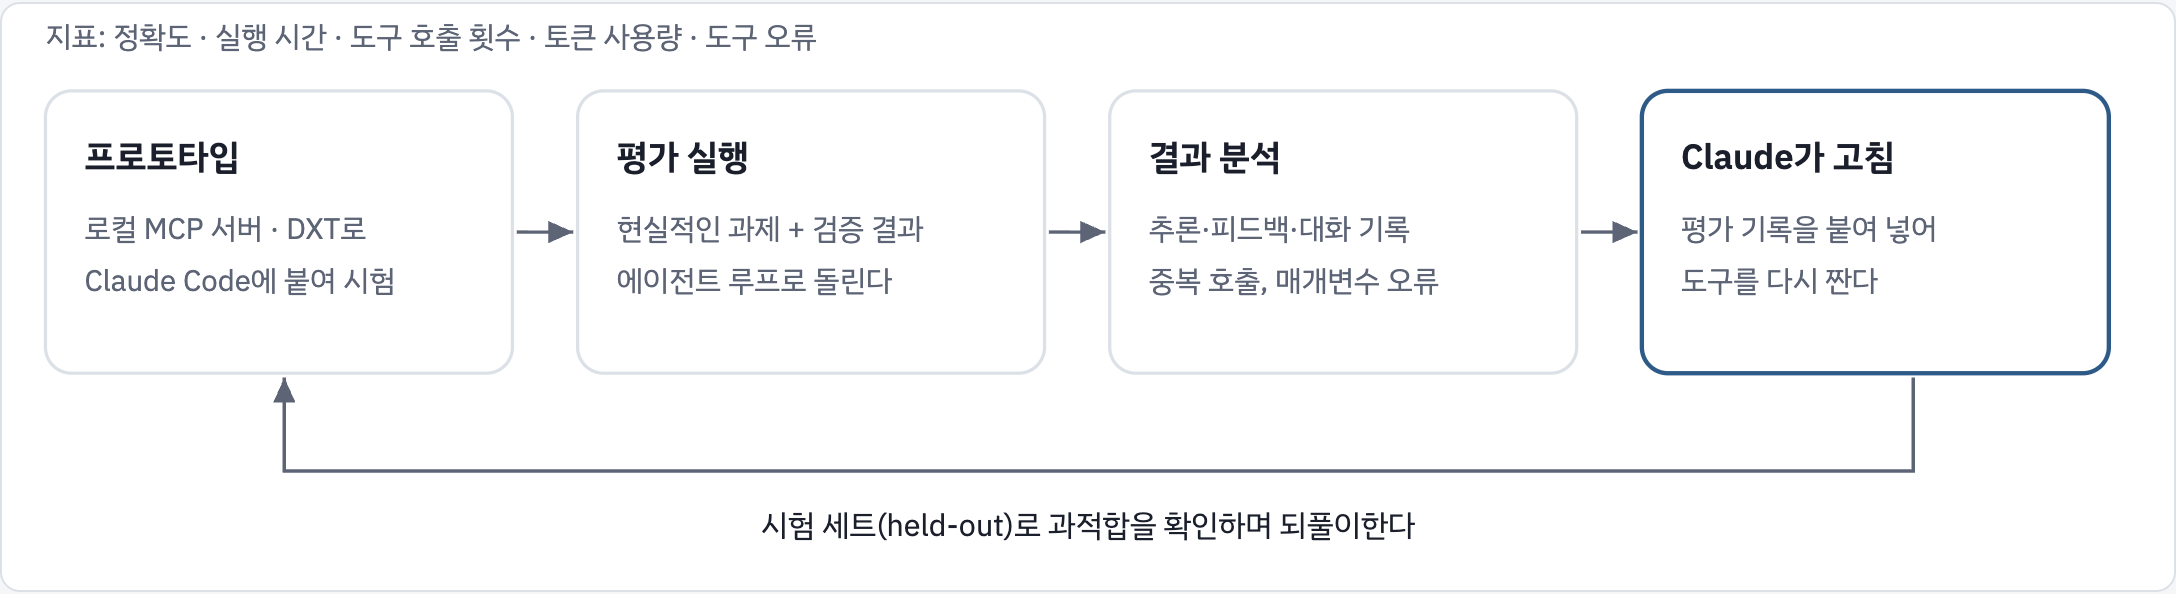
원문은 먼저 도구의 프로토타입을 빠르게 만들어 로컬에서 시험하고, 평가를 돌려 이후 변화를 재고, 에이전트와 함께 평가와 개선을 반복하라고 한다.
프로토타입
Claude Code로 도구를 만들 때는 도구가 기대는 라이브러리·API·SDK(소프트웨어 개발 키트) 문서를 Claude에게 주면 도움이 된다고 원문은 적는다. LLM이 읽기 좋은 문서는 공식 문서 사이트에
llms.txt라는 단순 텍스트 파일로 있는 경우가 많다고 한다.도구를 로컬 MCP 서버나 데스크톱 확장(DXT, Desktop extension)으로 감싸면 Claude Code나 Claude Desktop 앱에 붙여 시험할 수 있다. Claude Code에는
claude mcp add <name> <command> [args...]명령으로 붙인다. 도구를 Anthropic API 호출에 직접 넘겨 프로그램으로 시험하는 방법도 있다. 원문은 직접 써 보며 거친 부분을 찾고, 사용자에게 피드백을 받아 어떤 용도와 프롬프트가 나올지 감을 잡으라고 한다.평가 실행
평가(eval, evaluation)는 Claude가 도구를 얼마나 잘 쓰는지 재는 일이다. 원문은 현실의 사용을 바탕으로 한 평가 과제를 많이 만들라고 한다. Claude Code가 프로토타입을 훑어 보고 프롬프트와 응답 쌍을 수십 개 빠르게 만들 수 있다고 한다. 지나치게 단순한 샌드박스 환경은 피하라고 한다.
원문이 강한 과제로 드는 예는 다음과 같다. 강한 과제는 도구 호출을 수십 번 요구할 수도 있다.
- 다음 주에 Jane과 Acme Corp 최신 프로젝트를 논의하는 회의를 잡고, 지난 기획 회의 노트를 붙이고, 회의실을 예약한다.
- 고객 ID 9182가 한 번의 구매 시도에 세 번 결제됐다고 신고했다. 관련 로그를 모두 찾고 같은 문제를 겪은 다른 고객이 있는지 판단한다.
- 고객 Sarah Chen이 방금 해지를 신청했다. 왜 떠나는지, 어떤 제안이 가장 설득력 있는지, 제안 전에 알아야 할 위험 요인이 무엇인지 파악해 붙잡기 위한 제안을 준비한다.
약한 과제로 드는 예는 "jane@acme.corp와 다음 주에 회의를 잡는다", "결제 로그에서
purchase_complete와customer_id=9182를 검색한다", "고객 ID 45892의 해지 요청을 찾는다"이다.원문은 평가 프롬프트마다 검증할 수 있는 응답이나 결과를 짝지으라고 한다. 검증기는 정답과 표본 응답의 문자열 비교처럼 단순해도 되고, Claude에게 응답을 판정시켜도 된다. 서식이나 구두점 같은 사소한 차이로 맞는 응답을 거르는 지나치게 엄격한 검증기는 피하라고 한다.
평가는 LLM API를 직접 호출해 프로그램으로 돌린다. 원문은 과제마다 단순한 에이전트 루프(agentic loop)를 하나씩 쓰라고 한다. 루프는 LLM API 호출과 도구 호출을 번갈아 감싸는
while문이다. 평가용 에이전트의 시스템 프롬프트에는 검증용 응답 블록뿐 아니라 추론(reasoning)과 피드백 블록도 출력하게 하라고 권한다. 이 블록을 도구 호출과 응답 블록보다 먼저 출력하게 하면 연쇄 추론(CoT, chain-of-thought) 동작을 일으켜 LLM의 실효 지능을 높일 수 있다고 한다. Claude로 평가한다면 인터리브드 씽킹(interleaved thinking, 모델이 중간중간 추론을 내놓게 하는 기능)을 켜 비슷한 효과를 바로 얻을 수 있다고 한다.모을 지표로 원문은 정확도에 더해 개별 도구 호출과 과제의 전체 실행 시간, 도구 호출 횟수, 토큰 사용량, 도구 오류를 든다. 토큰은 모델이 읽고 쓰는 텍스트의 단위다. 도구 호출을 추적하면 에이전트가 자주 따르는 작업 흐름이 드러나고, 도구를 합칠 기회도 보인다고 한다.
결과 분석
원문은 에이전트가 모순된 도구 설명부터 비효율적인 구현, 헷갈리는 스키마까지 문제를 짚어 주는 좋은 동료라고 한다. 다만 에이전트가 피드백과 응답에서 빼놓은 것이 넣은 것보다 중요할 때가 많고, LLM이 늘 속뜻을 말하지는 않는다고 덧붙인다. 그래서 추론과 피드백을 읽고, 추론에 드러나지 않은 동작은 도구 호출과 응답이 담긴 원본 기록(transcript)에서 확인하라고 한다.
지표를 읽는 법도 적는다. 중복 호출이 많으면 페이지네이션(결과를 나눠 돌려주는 방식)이나 토큰 한도 매개변수를 알맞게 조정해야 할 수 있다. 잘못된 매개변수로 인한 오류가 많으면 설명을 더 분명히 하거나 예시를 더해야 할 수 있다. 원문이 든 사례는 Claude의 웹 검색 도구다. 출시 때 Claude가
query매개변수에 쓸데없이2025를 붙여 검색 결과가 치우치고 성능이 떨어지는 것을 발견했고, 도구 설명을 고쳐 바로잡았다.에이전트와 함께 고치기
원문은 에이전트가 결과를 분석하고 도구를 고치게 할 수도 있다고 한다. 평가 에이전트들의 기록을 이어 붙여 Claude Code에 붙여 넣으면 된다. Claude는 기록을 분석하고 여러 도구를 한꺼번에 고치는 데 능하다고 한다. 예를 들어 변경이 생겨도 도구 구현과 설명이 서로 어긋나지 않게 한꺼번에 맞출 수 있다. 원문은 이 글의 조언 대부분이 Claude Code로 내부 도구 구현을 거듭 최적화하며 나왔다고 적는다.
Anthropic은 내부 작업 공간 위에 평가를 만들었다. 실제 프로젝트, 문서, 메시지가 있어 내부 업무의 복잡도를 그대로 담았다. 훈련용 평가에 과적합(평가 문제에만 잘 맞게 고쳐지는 것)하지 않도록 따로 떼어 둔 시험 세트(held-out test set)도 썼다. 원문은 이 시험 세트에서, 연구자가 직접 쓰거나 Claude가 만든 "전문가" 도구 구현을 넘어서는 성능 개선을 더 뽑아낼 수 있다는 것이 드러났다고 적는다.
2부. 효과적인 도구를 위한 다섯 원칙
Anthropic은 이 원칙들이 위 과정, 곧 Claude Code로 내부 도구 구현을 거듭 최적화하며 얻은 배움을 추린 것이라고 소개한다.
맞는 도구를 고른다
"도구가 많다고 결과가 늘 좋아지는 것은 아니다"라고 원문은 적는다. 흔한 실수는 기존 소프트웨어 기능이나 API 엔드포인트(API가 요청을 받는 주소)를 그대로 감싸기만 한 도구다. 에이전트는 전통적인 소프트웨어와 도구를 인식하는 방식(affordance)이 다르기 때문이다. LLM 에이전트는 한 번에 처리할 수 있는 정보가 한정된 컨텍스트를 가지는 반면 컴퓨터 메모리는 싸고 넉넉하다.
원문이 드는 예는 주소록에서 연락처를 찾는 일이다. 모든 연락처를 돌려주는 도구를 쓰면 에이전트는 그것을 토큰 단위로 처음부터 읽느라 한정된 컨텍스트를 관련 없는 정보에 쓰게 된다. 원문은 에이전트에게나 사람에게나 관련 있는 쪽으로 먼저 건너뛰는 편이 더 낫고 자연스럽다고 한다. 그래서
list_contacts대신search_contacts나message_contact를 만들라고 권한다. 평가 과제에 맞는 영향이 큰 작업 흐름을 겨냥한 도구를 몇 개 만들고, 거기서 늘려 가라는 것이다.도구는 기능을 합쳐 속으로 여러 작업(API 호출)을 처리할 수 있다. 원문의 예는 이렇다.
list_users,list_events,create_event대신, 빈 시간을 찾아 일정을 잡는schedule_event하나read_logs대신, 관련 로그 줄과 앞뒤 맥락만 돌려주는search_logsget_customer_by_id,list_transactions,list_notes대신, 고객의 최근 관련 정보를 한꺼번에 모아 주는get_customer_context
원문은 도구마다 목적이 분명하고 서로 달라야 한다고 한다. 도구가 너무 많거나 겹치면 에이전트가 효율적인 전략을 놓칠 수 있다고 한다.
네임스페이싱 — 공통 접두어로 도구를 묶는다
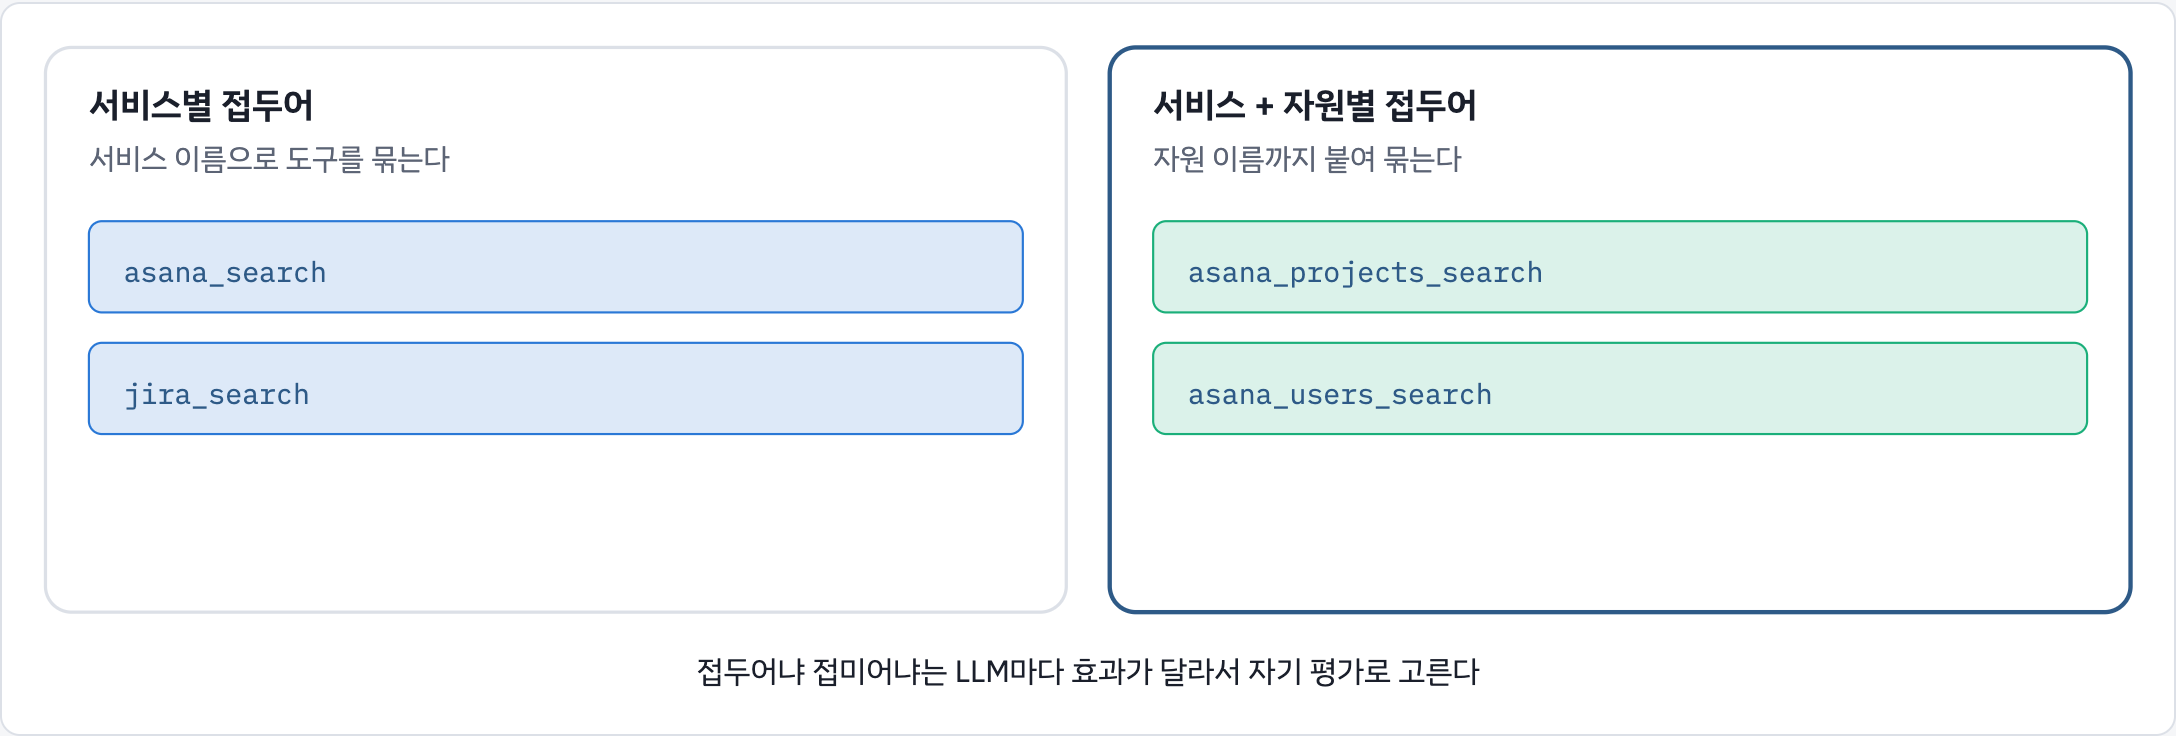
원문은 에이전트가 수십 개의 MCP 서버와 수백 개의 도구를 쓰게 될 수 있다고 적는다. 도구의 기능이 겹치거나 목적이 모호하면 에이전트는 무엇을 쓸지 헷갈린다. 네임스페이싱(namespacing)은 관련 있는 도구를 공통 접두어로 묶는 것이고, 도구 사이의 경계를 구분하는 데 도움이 된다. MCP 클라이언트가 기본으로 이렇게 하기도 한다. 원문의 예는 서비스별(
asana_search,jira_search)과 자원별(asana_projects_search,asana_users_search) 이름이다.Anthropic은 접두어(prefix) 방식과 접미어(suffix) 방식 가운데 무엇을 고르느냐가 도구 사용 평가에 가볍지 않은 영향을 줬다고 한다. 효과는 LLM마다 다르므로 자기 평가로 이름 짓는 방식을 고르라고 권한다.
의미 있는 맥락을 돌려준다
도구는 신호가 높은 정보만 에이전트에게 돌려줘야 한다고 원문은 말한다. 유연성보다 맥락의 관련성을 앞세우고,
uuid,256px_image_url,mime_type같은 낮은 수준의 기술 식별자는 피하라는 것이다.name,image_url,file_type같은 필드가 에이전트의 다음 행동과 응답에 바로 도움이 될 가능성이 훨씬 크다. 에이전트는 알아보기 어려운 식별자보다 자연어 이름과 용어를 훨씬 잘 다룬다고도 한다. Anthropic은 영숫자 UUID를 의미가 통하는 말(또는 0부터 시작하는 번호 체계)로 바꾸기만 해도 환각이 줄어 Claude의 정보 조회(retrieval) 과제 정밀도가 크게 좋아졌다고 적는다.다만 에이전트가 자연어와 기술 식별자를 모두 다뤄야 할 때가 있다고 한다. 예를 들어
search_user(name='jane')다음에send_message(id=12345)를 호출할 때다. 원문은 도구에response_format열거형(enum, 정해진 값 중 하나를 고르는 매개변수 타입)을 두라고 한다. 에이전트가 응답을 "concise"로 받을지 "detailed"로 받을지 고를 수 있게 하는 것이다. 원문의 예는DETAILED = "detailed",CONCISE = "concise"두 값이다. 원문은 GraphQL처럼 원하는 정보만 고르는 형식을 더 추가해도 된다고 한다.원문이 든 Slack 도구 예에서 자세한 응답은 206토큰이고 간결한 응답은 72토큰이다. 간결한 응답은 약 3분의 1의 토큰을 쓴다. Slack 스레드와 답글은 고유한
thread_ts로 식별되고, 답글을 가져오려면 이 값이 필요하다. 자세한 응답에는thread_ts와 다른 ID(channel_id,user_id)가 들어 있어 이 값이 필요한 후속 호출을 할 수 있다. 간결한 응답은 스레드 내용만 돌려주고 ID는 뺀다.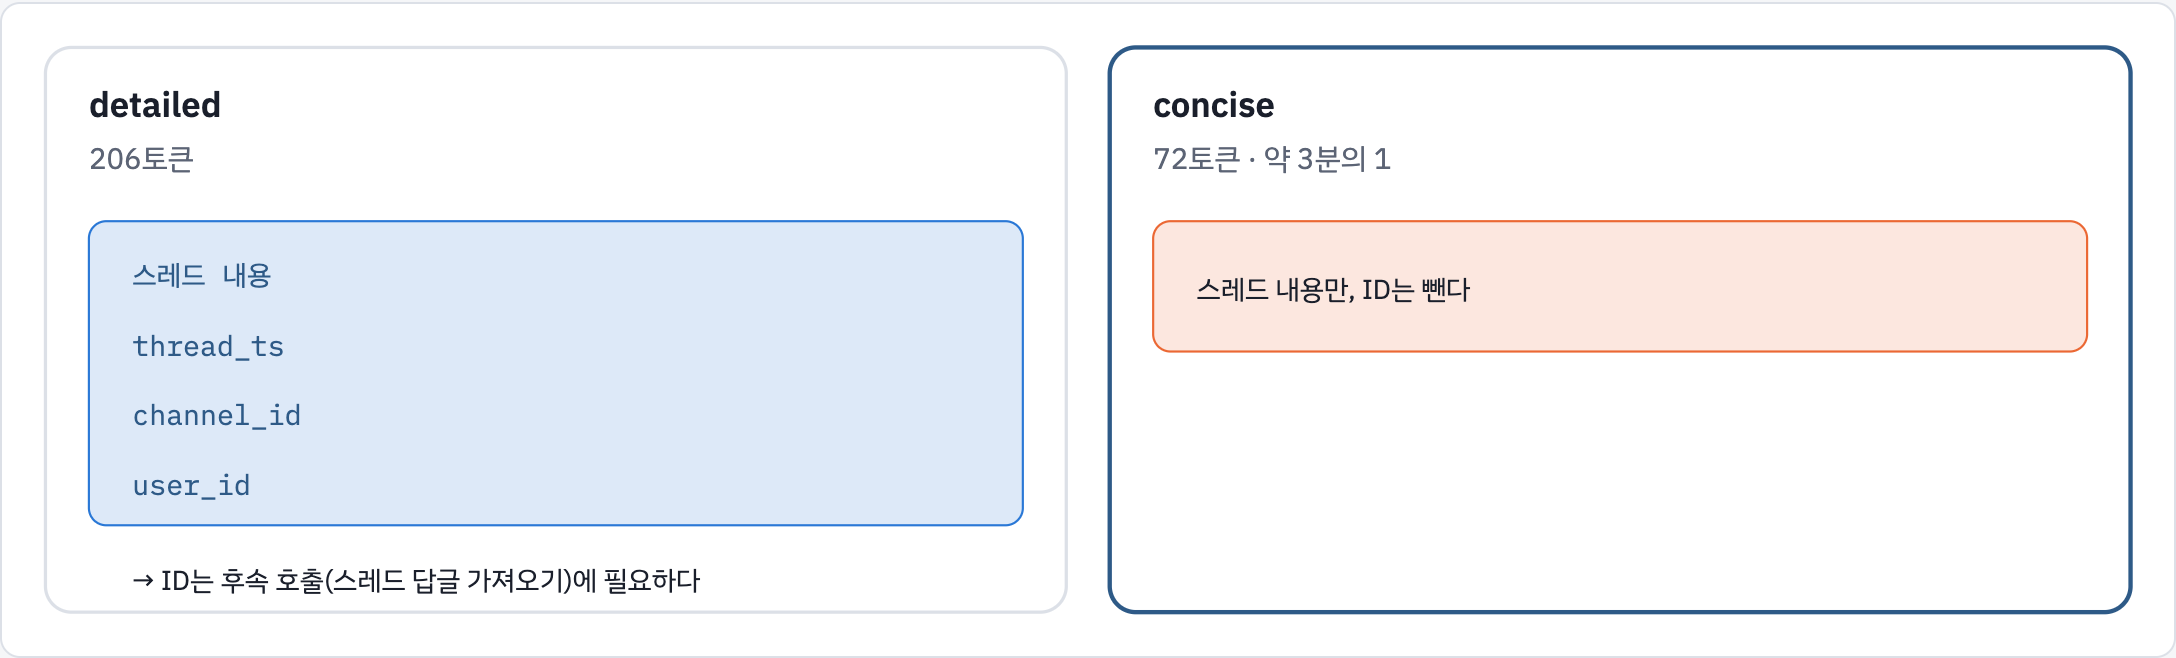
원문은 응답의 구조(XML, JSON, Markdown)도 평가 성능에 영향을 준다고 적는다. LLM은 다음 토큰 예측으로 훈련되어 훈련 데이터와 비슷한 형식에서 더 잘 동작하는 경향이 있기 때문이다. 만능 해법은 없고, 과제와 에이전트에 따라 최적이 다르니 자기 평가로 고르라고 한다.
토큰 효율을 챙긴다
컨텍스트의 질뿐 아니라 양도 중요하다고 원문은 말한다. 컨텍스트를 많이 쓸 수 있는 도구 응답에는 페이지네이션, 범위 선택, 필터링, 잘라내기(truncation) 중 몇 가지를 알맞은 기본값과 함께 구현하라고 제안한다. Claude Code는 도구 응답을 기본 25,000토큰으로 제한한다. Anthropic은 에이전트의 유효 컨텍스트 길이가 시간이 갈수록 늘겠지만 컨텍스트 효율적인 도구의 필요는 남을 것으로 내다본다.
응답을 자를 때는 도움이 되는 안내로 에이전트를 이끌라고 한다. 넓은 검색 한 번보다 작고 구체적인 검색을 여러 번 하는 식으로 토큰 효율이 좋은 전략을 쓰도록 직접 권할 수 있다. 입력 검증 같은 곳에서 오류가 날 때도 오류 응답을 프롬프트처럼 다듬어(prompt-engineer), 알아보기 어려운 오류 코드나 스택 트레이스(오류가 난 코드 위치 목록) 대신 구체적이고 실행할 수 있는 개선 방법을 알리라고 한다. 잘라낸 응답과 오류 응답은 에이전트를 필터나 페이지네이션 쪽으로 이끌거나 올바른 입력 형식의 예를 보여 줄 수 있다.
도구 설명을 프롬프트처럼 다듬는다
원문은 도구 설명과 명세를 프롬프트처럼 다듬는 것을 도구를 개선하는 가장 효과적인 방법 가운데 하나로 꼽는다. 프롬프트 엔지니어링(prompt engineering)은 모델이 읽는 글을 다듬어 동작을 이끄는 일이다. 도구 설명과 명세는 에이전트의 컨텍스트에 올라가므로 도구 호출 행동을 이끌 수 있다는 것이다.
원문은 팀에 새로 들어온 사람에게 도구를 설명하듯 쓰라고 한다. 특수한 질의 형식, 낯선 용어의 정의, 자원 사이의 관계처럼 쓰는 사람이 암묵적으로 품고 있는 맥락을 드러내라는 뜻이다. 기대하는 입력과 출력은 모호하지 않게 설명하고, 엄격한 데이터 모델로 강제하라고 한다. 입력 매개변수 이름도 분명해야 한다.
user라는 이름보다user_id가 낫다고 한다. 평가가 있으면 이런 다듬기의 영향을 더 자신 있게 잴 수 있고, 도구 설명을 조금만 고쳐도 크게 좋아질 수 있다고 한다. 원문은 Anthropic이 도구 설명을 정밀하게 다듬은 뒤 Claude Sonnet 3.5가 SWE-bench Verified 평가에서 최고 성능(state-of-the-art)을 냈고, 오류율은 크게 줄고 과제 완료는 늘었다고 적는다.마치며
원문은 에이전트용 도구를 잘 만들려면 소프트웨어 개발 방식을 예측 가능한 결정적 패턴에서 비결정적 패턴으로 바꿔야 한다고 말한다. 평가를 바탕으로 한 반복 과정에서 Anthropic이 찾은 공통점은 이렇다. 효과적인 도구는 의도와 정의가 분명하고, 에이전트의 컨텍스트를 아껴 쓰고, 여러 작업 흐름에서 조합할 수 있고, 에이전트가 현실의 과제를 직관적으로 풀게 한다.
원문은 에이전트가 세상과 상호작용하는 구체적인 방식이 MCP 프로토콜의 갱신이나 기반 LLM의 개선으로 바뀔 것으로 예상한다. 그래도 평가를 바탕으로 도구를 체계적으로 개선하면, 에이전트가 더 유능해져도 그들이 쓰는 도구가 함께 발전하게 할 수 있다고 한다.
도구를 에이전트에 맞춰 설계한다는 주제는 이 시리즈의 다른 글에도 나온다. 도구와 데이터를 잇는 규격은 MCP 명세 읽기에서, 에이전트에게 맞춘 인터페이스는 SWE-agent 논문 읽기에서 다뤘다.
참고
- Writing effective tools for agents — with agents — Anthropic (2025-09-11)
'AI 하네스' 카테고리의 다른 글
승인 창 대신 경계를 긋는다 — Claude Code 샌드박스 읽기 (0) 2026.10.18 How we built our multi-agent research system 읽기 — 병렬 서브에이전트로 만든 리서치 시스템 (0) 2026.10.18 Building effective agents 읽기 — 워크플로와 에이전트 (0) 2026.10.18 컨텍스트 엔지니어링 문서 읽기 — Anthropic이 정리한 기법 (0) 2026.10.18 MCP 명세 읽기 — 2026-07-28 개정판까지 (0) 2026.10.18 댓글